
O problema
Simuladores de comportamento baseados em LLM produzem saídas plausíveis por construção. Um relatório coerente, com agentes sintéticos que justificam suas decisões de forma articulada, é indistinguível de um relatório correto quando você só olha para ele.
O agravante é que previsão de comportamento social raramente é falsificável na prática. Quando a previsão se confirma, valida a ferramenta. Quando não se confirma, o mundo mudou. Essa assimetria permite que uma ferramenta sem acurácia nenhuma pareça funcionar por tempo indeterminado.
Instituições financeiras precisam antecipar como a base reagirá a mudanças de política. Modelos estatísticos fazem isso bem quando há precedente histórico. O vazio aparece nas mudanças inéditas, que não têm série temporal para ajustar curva. É nesse vazio que simuladores de agentes se apresentam como solução.
O desenho
Cinco arquétipos de clientes de uma instituição de meios de pagamento, definidos manualmente com atributos econômicos concretos: faturamento em cartão, participação de crédito à vista, margem líquida e, a variável que se provou decisiva, resistência à migração numa escala de 0 a 10.
O cenário testado foi um aumento de MDR de 2,99% para 3,49%. O MDR é a taxa que o lojista paga sobre cada venda no cartão, e meio ponto percentual é o tipo de mudança que dói sem ser absurda.
A peça central do desenho é o braço de controle. Todo cenário roda duas vezes:
- Tratamento: aumento de 0,50 ponto percentual
- Controle: aumento de 0,01 ponto percentual, que custa R$ 0,31 por mês ao microempreendedor
Todo o resto é idêntico. Mesma comunicação, mesmo contexto competitivo, mesmas personas, mesma temperatura. Se o modelo estiver de fato avaliando impacto econômico, os dois resultados precisam ser muito diferentes.
Cálculo determinístico fora do LLM
O impacto financeiro é computado em Python antes da chamada e entregue pronto no prompt, em reais e em percentual da margem. O modelo não estima magnitude, ele recebe.
| Segmento | Faturamento/mês | Custo adicional/mês | % da margem |
|---|---|---|---|
| Micro | R$ 7.000 | R$ 15,75 | 1,88% |
| Lojista | R$ 60.000 | R$ 120,00 | 2,00% |
| E-commerce | R$ 180.000 | R$ 495,00 | 3,44% |
| Enterprise | R$ 2.500.000 | R$ 6.250,00 | 4,17% |
| Dormente | R$ 900 | R$ 1,80 | 1,33% |
A primeira versão estava errada
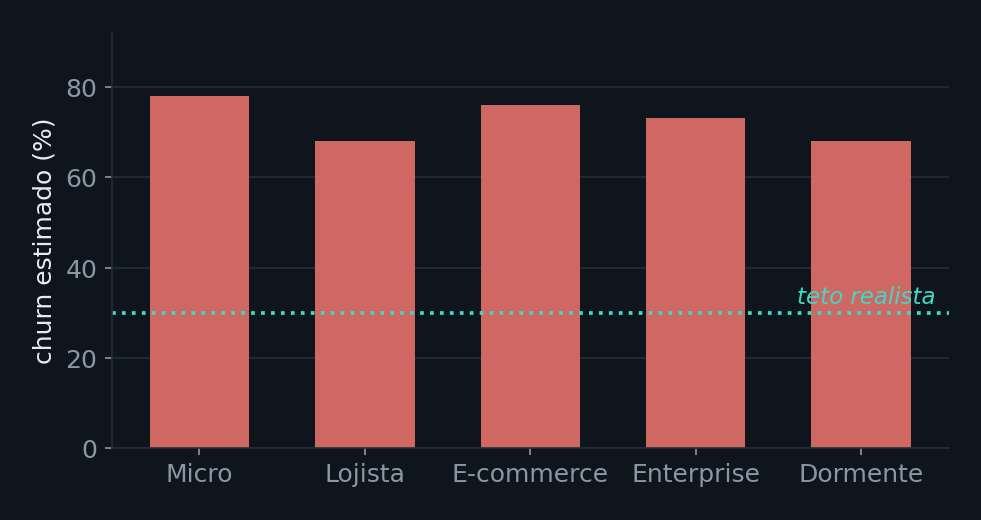
Meio ponto percentual de MDR não expulsa dois terços de nenhuma base. Pior que o valor absoluto, a diferenciação entre perfis havia colapsado por completo. O atributo que deveria dominar a decisão, o custo de trocar de fornecedor, foi simplesmente ignorado.
Um sinal passou despercebido no primeiro momento: as objeções geradas reclamavam de falta de aviso prévio. O cenário especificava trinta dias de antecedência por três canais. O modelo estava respondendo ao tema, não ao conteúdo do input.
O que o placebo revelou
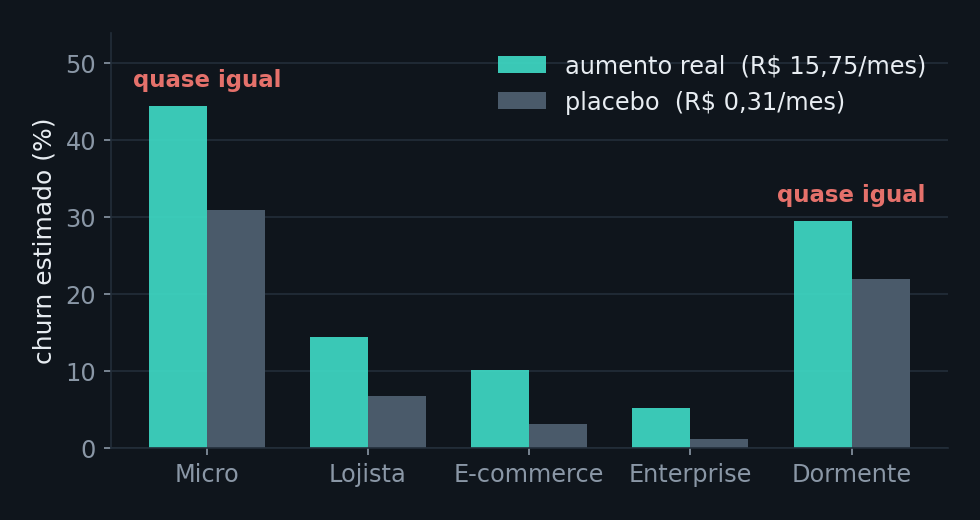
A métrica que organiza tudo é a razão entre tratamento e placebo. Razão próxima de 1 significa que o segmento não distingue os dois cenários, ou seja, está reagindo à existência do aumento e não ao seu tamanho.
| Segmento | Resistência | Razão | Status |
|---|---|---|---|
| Enterprise com contrato | 9 | 4,1x | aprovado |
| E-commerce integrado | 7 | 3,3x | aprovado |
| Lojista de porte médio | 4 | 2,4x | aprovado |
| Microempreendedor | 1 | 1,3x | descartado |
| Baixo uso / dormente | 0 | 1,5x | descartado |
O achado
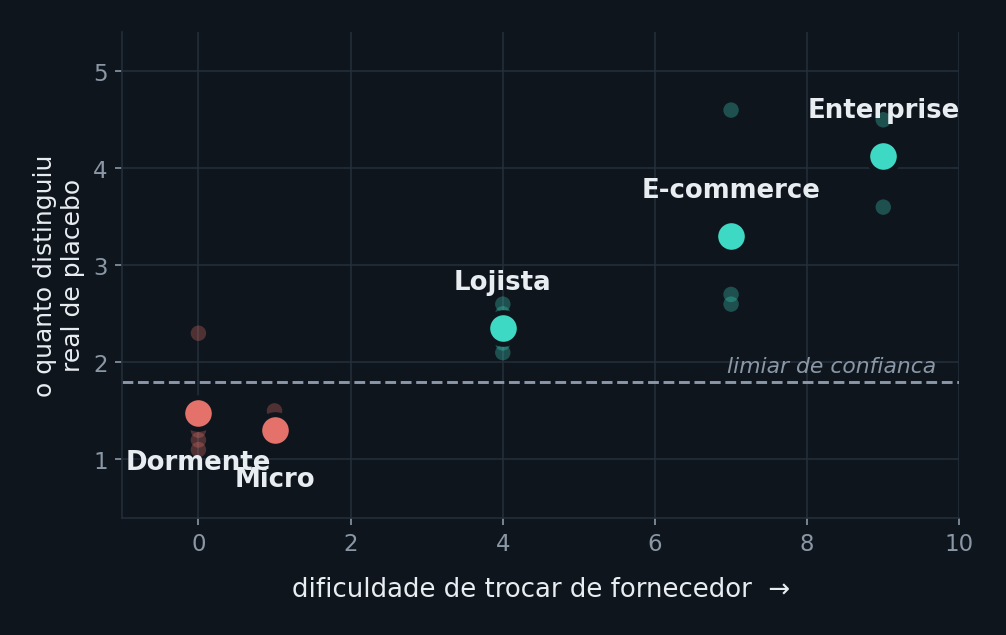
A simulação por LLM é confiável onde existe fricção estrutural, como contrato, integração técnica ou custo de migração. E vira ruído onde a decisão é de baixo atrito.
Isso inverte a expectativa. Seria natural supor que um simulador de comportamento acerta mais onde o comportamento é simples e erra onde é complexo. Acontece o contrário.
Quando existe fricção, ela funciona como âncora que restringe o espaço de decisões plausíveis. O modelo não precisa avaliar bem a magnitude do aumento. Basta reconhecer que aquele cliente está preso por contrato, e a resposta correta se impõe. A fricção faz o trabalho que o raciocínio econômico deveria fazer.
Sem fricção, não sobra nada restringindo. O modelo cai no roteiro narrativo mais disponível, que é cliente sem fidelidade vê aumento e vai embora, e o executa independentemente de o aumento ser meio ponto ou um centésimo.
A evidência mais direta
Numa das rodadas, o segmento dormente produziu simultaneamente:
"probabilidade_churn": 0.50,
"acao_provavel": "nao_faz_nada"
Metade da base saindo, e a ação declarada é não fazer nada. Dois campos contraditórios dentro da mesma resposta. Sem fricção estrutural para ancorar a decisão, o modelo não sustenta nem coerência interna.
A inversão econômica
Um resultado colateral, e possivelmente o mais acionável para quem toma decisão de preço: quem mais perde dinheiro com o aumento é quem menos consegue sair.
Meio ponto de MDR custa R$ 15,75 por mês ao microempreendedor e R$ 6.250 ao enterprise. Quatrocentas vezes mais em valor absoluto, e é o enterprise quem está preso por contrato, SLA e homologação.
- O microempreendedor perde pouco em valor absoluto, mas é sensível na percepção e migra sem esforço. O risco é de evasão silenciosa e em massa.
- O enterprise perde muito e não pode sair no curto prazo. O risco não é churn imediato. É deterioração da relação, escalonamento executivo e renegociação hostil na renovação.
Um modelo de churn agregado sobre a base inteira não separa esses dois fenômenos. Ele produz um número médio que descreve mal os dois.
O custo de não validar
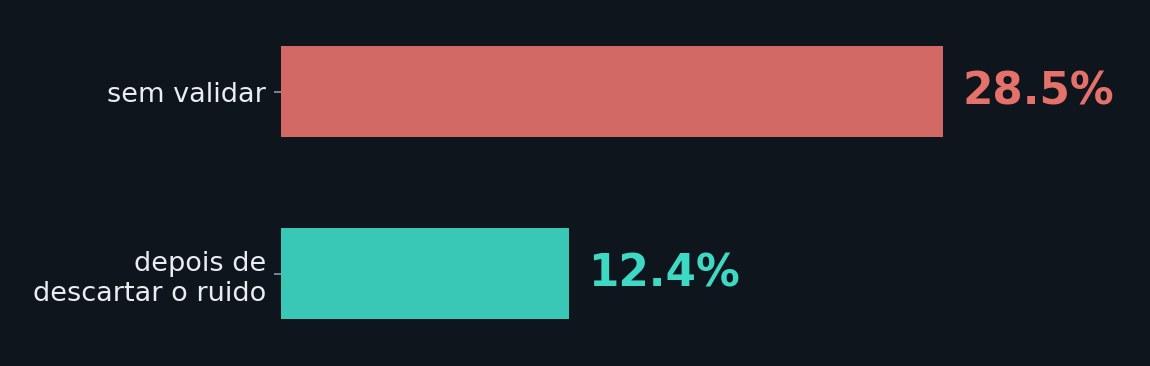
Um relatório de simulação que apresenta "28,5% de churn projetado" sem grupo de controle não está errado por descuido. Está apresentando um número que não tem como sustentar, com precisão aparente e nenhuma base.
Reprodutibilidade
O experimento completo foi repetido quatro vezes com o mesmo modelo e os mesmos parâmetros. Os segmentos aprovados variaram menos de 4 pontos percentuais entre execuções. Os descartados variaram até 10.
O detalhe mais instrutivo está no segmento dormente. Em uma das execuções sua razão de validade foi 2,3x, o que teria passado no critério. Em outra, 1,1x. A própria métrica que mede se aquele segmento é confiável oscila quase pela metade entre execuções idênticas.
Uma execução isolada pode dar a impressão de que um segmento instável é utilizável. Só a replicação revela. Por isso o repositório inclui um script de comparação entre execuções.
Conclusões
Sobre a técnica
- A fronteira entre estimativa utilizável e ruído é detectável e mensurável, e acompanha a fricção estrutural do segmento.
- A capacidade do modelo importa mas não resolve. O gpt-4o discriminou muito melhor que o gpt-4o-mini nos segmentos de alta fricção, e foi pior no microempreendedor.
- Cálculo determinístico fora do LLM é o que mais melhora resultado. Tudo que puder ser computado deve ser computado e entregue pronto.
Sobre método
- Grupo de controle deveria ser obrigatório em ferramentas desse tipo. Dobra um custo de execução que já é irrisório e é a única forma de distinguir sinal de roteiro narrativo.
- Validação precisa ser por segmento. Critérios agregados são instáveis e mascaram resultados bons e ruins ao mesmo tempo.
- Replicar sempre, e reportar faixas em vez de valores pontuais.
Sobre uso responsável
A ferramenta serve para levantar objeções que ninguém considerou, comparar variantes de comunicação, identificar segmentos negligenciados e preparar respostas antes de um anúncio. Nesses usos, ser diretamente falsificável importa menos.
Não serve para produzir número que vai a comitê. As âncoras de escala usadas são convenções razoáveis, não estatística do setor. O passo que transformaria isto em ferramenta calibrada é substituí-las por histórico próprio, rodando retroativamente uma mudança já ocorrida e comparando a previsão com o churn efetivamente observado.
Enquanto esse passo não for dado, o output é exploratório. Dizer isso não enfraquece a ferramenta. É o que permite usá-la sem produzir dano.